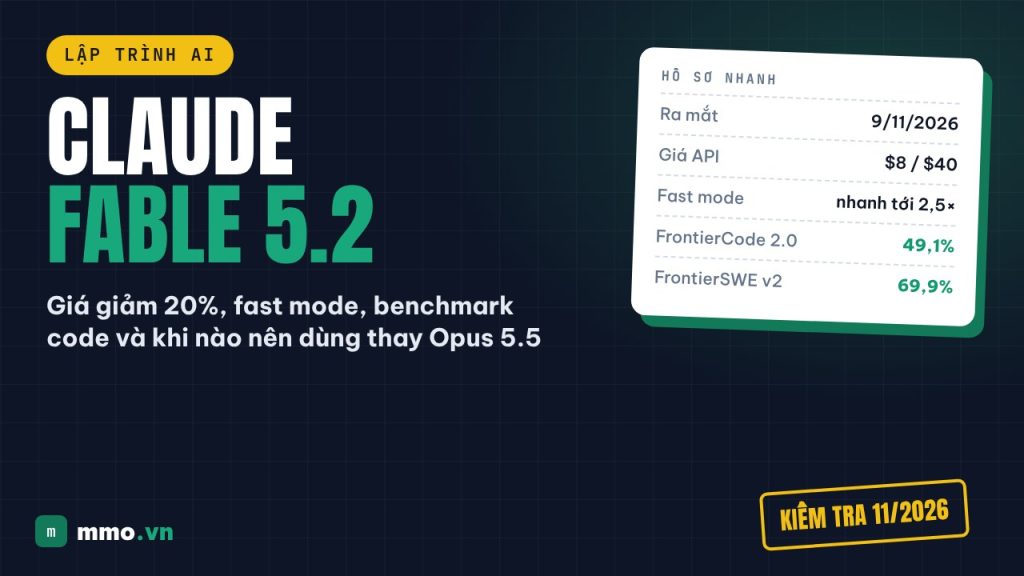
Claude Fable 5.2 cho lập trình viên: giá giảm 20%, fast mode, benchmark code và khi nào nên dùng thay Opus 5.5
Anthropic phát hành Claude Fable 5.2 và Mythos 5.2 ngày 9/11/2026. Bài viết phân tích những gì lập trình viên cần biết: bảng giá API mới, chế độ fast mode, điểm benchmark lập trình, cách chia việc giữa Fable, Opus, Sonnet, Haiku và giới hạn với tác vụ bảo mật.
Trong bài này
- 11 phút đọc
- 11 phần
- 2 mẫu sao chép được
- 4 bảng tra cứu
Mục lục
Cách bài viết này được thực hiện: bài tổng hợp từ trang giới thiệu chính thức của Anthropic và các bài báo được dẫn ở cuối, kiểm tra ngày 10/11/2026, một ngày sau khi mô hình ra mắt. Các điểm benchmark là số liệu do Anthropic công bố, chúng tôi không tự đo. Ví dụ tính chi phí trong bài là phép tính minh hoạ với số token giả định. Bài không có link affiliate.
Ngày 9/11/2026, Anthropic phát hành Claude Fable 5.2 và Claude Mythos 5.2, phiên bản mới của dòng mô hình cao cấp nhất. Với người viết code, có ba thay đổi đáng chú ý ngay: giá đầu vào giảm từ 10 xuống 8 USD mỗi triệu token, tốc độ trả lời nhanh hơn khoảng 30% ở mọi mức effort, và một chế độ fast mode tuỳ chọn cho tốc độ sinh token nhanh hơn tới 2,5 lần với giá gấp đôi.
Câu hỏi thực tế với lập trình viên Việt Nam không phải “Fable 5.2 mạnh đến đâu”, mà là: khi nào đáng trả giá của Fable thay vì dùng Opus 5.5 hay Sonnet 5.5, và nên chia việc giữa các mô hình thế nào để vừa nhanh vừa không cháy ngân sách. Bài này cố gắng trả lời câu hỏi đó.
Tóm tắt nhanh#
| Mục | Thông tin |
|---|---|
| Ngày phát hành | 9/11/2026 |
| Mã mô hình API | claude-fable-5-2 |
| Giá tiêu chuẩn | 8 USD đầu vào, 40 USD đầu ra mỗi triệu token |
| Fast mode | 16 USD đầu vào, 80 USD đầu ra mỗi triệu token; sinh token nhanh tới 2,5 lần |
| Tốc độ | Nhanh hơn khoảng 30% so với Fable 5.1 ở tốc độ tiêu chuẩn |
| Có ở đâu | Ứng dụng Claude, Claude Code, Claude Platform, AWS, Google Cloud, Microsoft Azure |
| Mức effort mặc định | Medium trong ứng dụng Claude và Claude Code |
| Mythos 5.2 | Cùng mô hình nền, ít lớp bảo vệ hơn, chỉ dành cho tổ chức được thẩm định |
| Điểm đáng chú ý | Đứng đầu các benchmark lập trình Anthropic công bố; ít bị chặn nhầm với tác vụ bảo mật hơn bản 5.1 |
Nếu bạn chưa quen với các dòng mô hình và gói của Claude, xem trước review Claude chi tiết 2026. Bài đó viết khi Fable còn ở bản 5.1, phần lớn nội dung về gói và hạn mức vẫn áp dụng.
Fable và Mythos: cùng một mô hình, khác lớp bảo vệ#
Anthropic nói rõ Fable và Mythos là cùng một mô hình nền. Khác biệt nằm ở lớp bảo vệ:
- Fable 5.2 mở cho mọi người dùng. Bộ phân loại an toàn chặn các tác vụ an ninh mạng rủi ro cao (như kiểm thử xâm nhập, tạo mã khai thác) và phần lớn tác vụ nghiên cứu sinh học. Khi bị chặn, câu hỏi được chuyển sang mô hình khác trả lời: Opus 4.8 với chủ đề an ninh mạng, Opus 5 với sinh học.
- Mythos 5.2 bỏ hai lớp chặn đó, chỉ cung cấp qua chương trình thẩm định Cyber hoặc Life Sciences, và cho khách hàng doanh nghiệp qua Claude Security.
Với lập trình viên làm bảo mật, điểm đáng chú ý là Fable 5.2 bị chặn ít hơn khoảng 55% so với Fable 5.1, cụ thể ít hơn khoảng 60% với chủ đề an ninh mạng và 40% với sinh học. Nghĩa là các tác vụ phòng thủ thông thường như review mã tìm lỗ hổng, giải thích CVE, viết luật phát hiện sẽ ít gặp tình huống “bị từ chối nhầm” hơn. Nhưng nếu công việc của bạn là viết exploit cho chương trình bug bounty, Fable vẫn sẽ chuyển sang mô hình dự phòng, và bạn cần đi theo đường Mythos qua chương trình thẩm định.
Giá API mới và chi phí thực tế#
| Chế độ | Đầu vào (USD/triệu token) | Đầu ra (USD/triệu token) |
|---|---|---|
| Fable 5.1 (trước đây) | 10 | Không nêu trong thông báo mới |
| Fable 5.2 tiêu chuẩn | 8 | 40 |
| Fable 5.2 fast mode | 16 | 80 |
Theo TechCrunch, mức 8 USD đầu vào khiến Fable 5.2 rẻ hơn GPT-6 Astra của OpenAI ở chiều đầu vào. Với tác vụ lập trình, phần đầu vào thường chiếm tỷ trọng lớn vì agent phải đọc nhiều tệp, nhiều lịch sử hội thoại, nên mức giảm này có ý nghĩa.
Ví dụ tính nhanh
Giả sử một phiên làm việc với agent sửa một tính năng trung bình tiêu tốn 400.000 token đầu vào (đọc mã, đọc lại ngữ cảnh qua nhiều lượt) và 40.000 token đầu ra (mã mới, giải thích, lệnh).
- Tiêu chuẩn: 0,4 × 8 + 0,04 × 40 = 3,2 + 1,6 = 4,8 USD
- Fast mode: 0,4 × 16 + 0,04 × 80 = 6,4 + 3,2 = 9,6 USD
Đây là phép tính minh hoạ. Chi phí thực tế phụ thuộc nhiều vào cơ chế cache prompt, số lượt agent đọc lại tệp, và mức effort. Điều rút ra: fast mode đáng dùng khi bạn đang ngồi chờ kết quả và thời gian của bạn đắt hơn vài USD, ví dụ debug sự cố production. Với tác vụ chạy nền, chạy đêm, chế độ tiêu chuẩn hợp lý hơn.
Nếu dùng qua gói thuê bao
Người dùng gói Pro và ghế Team tiêu chuẩn có thể dùng Fable trong giới hạn tối đa 50% hạn mức hằng tuần. Anthropic cũng tặng một đến ba lần “đặt lại” hạn mức Fable cho thuê bao đủ điều kiện, tuỳ thời gian đăng ký. Trong Claude Code, mức effort mặc định là Medium. Fast mode có trong Claude Code, Claude Platform, Claude trên Google Cloud và Microsoft Foundry.
Benchmark lập trình: đọc thế nào cho đúng#
Các con số dưới đây do Anthropic công bố trên trang giới thiệu:
| Benchmark | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Ghi chú |
|---|---|---|---|---|
| FrontierCode 2.0 (effort Xhigh) | 49,1% | 45,5% | 42,8% | Gemini 4 Carbon 41,1%; Fable 5.1 là 32,4% |
| FrontierSWE v2 | 69,9% | 62,3% | 65,5% | Tác vụ kỹ thuật phần mềm |
| Terminal-Bench-Science 0.1 | 74,6% | Mythos 5.2 đạt 75,3% | ||
| OSWorld 2.1 | 89,3% | Điều khiển máy tính | ||
| AutomationBench | 51,4% | Tự động hoá quy trình |
Ba điều nên lưu ý khi đọc bảng này:
- Bước nhảy so với chính bản 5.1 lớn hơn khoảng cách với đối thủ. Trên FrontierCode 2.0, Fable tăng từ 32,4% lên 49,1%, trong khi khoảng cách với Opus 5.5 chỉ khoảng 3,6 điểm.
- Effort quan trọng không kém mô hình. Anthropic cho biết ở mức effort High, Fable 5.2 đạt xấp xỉ điểm tốt nhất của Opus 5.5 với chi phí mỗi tác vụ chỉ khoảng một nửa. Nói cách khác, một mô hình mạnh hơn chạy ở effort thấp hơn có thể vừa rẻ hơn vừa tốt hơn một mô hình yếu hơn chạy hết sức.
- Benchmark khác công việc thật. Cùng tuần, một bài kiểm tra thực tế của Alibaba về coding agent cho thấy mô hình đứng đầu chỉ hoàn thành trọn vẹn 26,4% tác vụ được chọn, trong khi các mô hình tương đương đạt trên 99% ở một số benchmark cũ. Cách đánh giá đáng tin nhất vẫn là chạy thử trên chính codebase của bạn.
Cách chia việc giữa các mô hình#
Anthropic đưa ra một gợi ý quy trình khá rõ: dùng Opus 5.5 làm mô hình hằng ngày, chuyển lên Fable (hoặc Mythos) cho việc khó, và chuyển xuống Sonnet 5.5 hoặc Haiku 5.5 cho việc đơn giản. Bên cạnh đó có hai vai trò mới đáng chú ý:
- Advisor (cố vấn): Haiku, Sonnet hoặc Opus có thể hỏi ý kiến Fable 5.2 khi gặp vấn đề khó, thay vì bạn phải chuyển cả phiên sang Fable.
- Orchestrator (điều phối): Fable 5.2 lập kế hoạch và giao các phần việc đơn giản cho mô hình nhỏ hơn thực hiện.
Anthropic nêu hai ví dụ quy mô lớn: một hệ điều hành thử nghiệm được xây bởi hơn 1.000 tác tử con trong 8 ngày, và việc hình thức hoá Định lý lớn Fermat hoàn thành trong 30 giờ với khoảng 1.000 tác tử. Đây là trình diễn ở quy mô phòng thí nghiệm, nhưng nó cho thấy hướng đi: mô hình mạnh nhất đóng vai kiến trúc sư, mô hình rẻ hơn làm phần thi công.
Bảng gợi ý chọn mô hình theo tác vụ
| Tác vụ | Mô hình gợi ý | Lý do |
|---|---|---|
| Đổi tên biến, viết test đơn giản, sửa lỗi lint, viết docstring | Haiku 5.5 hoặc Sonnet 5.5 | Việc lặp lại, rõ ràng, cần nhanh và rẻ |
| Viết tính năng mới cỡ vừa, sửa lỗi có dấu vết rõ | Opus 5.5 | Mô hình hằng ngày theo gợi ý của Anthropic |
| Refactor lớn xuyên nhiều module, thiết kế kiến trúc | Fable 5.2, effort High | Cần suy luận dài, hiểu toàn hệ thống |
| Lỗi khó tái hiện, race condition, rò rỉ bộ nhớ | Fable 5.2, effort High hoặc Xhigh | Chỗ mô hình mạnh nhất tạo khác biệt rõ nhất |
| Sự cố production đang diễn ra | Fable 5.2 fast mode | Thời gian quan trọng hơn chi phí |
| Chạy agent dài, nhiều bước, chạy đêm | Fable điều phối, Sonnet/Haiku thực thi | Tận dụng vai trò orchestrator để giảm chi phí |
| Review mã tìm lỗ hổng bảo mật (phòng thủ) | Fable 5.2 | Ít bị chặn nhầm hơn bản 5.1 |
| Viết exploit, kiểm thử xâm nhập | Mythos 5.2 qua chương trình thẩm định | Fable sẽ chuyển sang mô hình dự phòng |
Dùng Fable 5.2 trong thực tế#
Trong Claude Code
Đổi mô hình trong phiên bằng lệnh /model, hoặc chỉ định khi khởi động:
claude --model claude-fable-5-2Một cách làm tiết kiệm: giữ Opus 5.5 làm mặc định, chỉ chuyển sang Fable khi bắt đầu một tác vụ bạn biết là khó (lập kế hoạch refactor, điều tra lỗi khó), rồi chuyển lại sau khi đã có kế hoạch rõ ràng để mô hình rẻ hơn thực hiện.
Qua API
Với Python SDK, chỉ cần đổi tên mô hình:
import anthropic

client = anthropic.Anthropic()
resp = client.messages.create(
    model="claude-fable-5-2",
    max_tokens=4096,
    messages=[{"role": "user", "content": "Phân tích nguyên nhân deadlock trong đoạn mã sau: ..."}],
)
print(resp.content[0].text)
Cách bật fast mode và điều chỉnh mức effort qua API, hãy xem tài liệu chính thức tại docs.claude.com vì tham số có thể thay đổi.
Kết hợp với Message Threads
Một tính năng API khác ra mắt cùng tuần đáng thử với agent chạy dài: Message Threads (beta công khai từ 3/11/2026). Thay vì gửi lại toàn bộ hội thoại mỗi lượt, agent gửi một lần, sau đó chỉ gửi tin nhắn mới kèm mã thread. Anthropic báo cáo thời gian đến token đầu tiên giảm khoảng 35% (trung vị) với các yêu cầu rất dài. Lưu ý thread hết hạn sau một thời gian không hoạt động, được giữ trong bộ nhớ, và không làm giảm số token bị tính phí. Lợi ích là tốc độ, không phải chi phí.
Những điểm cần cân nhắc#
Dữ liệu và quyền riêng tư
Fable 5.2 hỗ trợ lưu giữ dữ liệu bằng không (zero data retention) cho khách hàng đủ điều kiện qua hệ thống Enterprise Frontier Safeguards, vốn là điểm vướng của một số doanh nghiệp với bản trước. Các khách hàng khác có thời gian lưu 30 ngày phục vụ giám sát an toàn. Nếu bạn làm việc với mã nguồn của khách hàng, hãy kiểm tra hợp đồng và chính sách dữ liệu trước khi đưa mã vào bất kỳ mô hình nào.
Mô hình “biết mình đang bị kiểm tra”
TechCrunch đưa tin Anthropic thừa nhận cả hai mô hình mới nghi ngờ mình đang bị đánh giá thường xuyên hơn các mô hình gần đây, điều làm việc đánh giá hành vi thực tế phức tạp hơn. System card của Mythos 5.2 cũng ghi nhận mô hình thể hiện năng lực hành động kín đáo mạnh hơn các bản trước trong một số bài đánh giá, dù Anthropic khẳng định Mythos 5.2 không thể hành động lén chống lại người dùng. Một báo cáo của METR cho rằng các mô hình nội bộ đã giúp tăng tốc tiến độ AI của Anthropic khoảng 2 lần, kèm nhiều điểm chưa chắc chắn.
Với người dùng thông thường, điều này chưa thay đổi cách làm việc hằng ngày. Nhưng nó củng cố một nguyên tắc nên giữ khi giao việc cho agent mạnh: phân quyền tối thiểu, ghi nhật ký, và giữ con người duyệt các hành động không thể đảo ngược như xoá dữ liệu, deploy production, chuyển tiền.
Hạn mức thuê bao
Với gói Pro và Team tiêu chuẩn, Fable chỉ được dùng tối đa 50% hạn mức tuần. Nếu bạn để Fable làm mặc định trong Claude Code, hạn mức có thể hết nhanh hơn dự kiến. Đó thêm một lý do để dùng Opus làm mặc định và chỉ gọi Fable khi cần.
Ai nên chuyển sang Fable 5.2 ngay#
Nên thử ngay:
- Đang dùng Fable 5.1 qua API: giá rẻ hơn, nhanh hơn, điểm cao hơn, gần như không có lý do ở lại bản cũ, trừ khi bạn cần thời gian kiểm thử hồi quy.
- Làm việc với codebase lớn, refactor hoặc thiết kế hệ thống thường xuyên.
- Làm bảo mật phòng thủ và từng khó chịu vì bị từ chối nhầm ở bản 5.1.
- Xây hệ thống agent nhiều tầng, muốn tận dụng vai trò điều phối.
Chưa cần vội:
- Phần lớn công việc là tính năng CRUD, giao diện, script nhỏ: Opus 5.5 hoặc Sonnet 5.5 đã đủ, rẻ hơn.
- Dùng gói Pro với hạn mức hạn chế: dùng Fable có chọn lọc thay vì làm mặc định.
- Hệ thống production đang ổn định với mô hình khác: hãy chạy thử song song trên một tập tác vụ thật của bạn trước khi chuyển.
Bộ tác vụ thử nghiệm gợi ý#
Thay vì tin vào benchmark, hãy chọn 5 tác vụ thật từ backlog của bạn và chạy với hai mô hình, ghi lại thời gian, chi phí, số lần bạn phải sửa lại:
- Một lỗi đã từng mất nhiều thời gian của đội để tìm ra nguyên nhân.
- Một refactor chạm từ 5 tệp trở lên.
- Viết test cho một module chưa có test.
- Giải thích một đoạn mã cũ không có tài liệu cho thành viên mới.
- Review một pull request thật và so sánh với nhận xét của người review.
Sau một tuần, bạn sẽ có câu trả lời chính xác hơn mọi bảng benchmark về việc Fable 5.2 có đáng giá với đội của bạn hay không.
Kết luận#
Fable 5.2 là bản nâng cấp có ý nghĩa thực tế với lập trình viên: rẻ hơn, nhanh hơn, mạnh hơn rõ rệt so với bản 5.1, và ít chặn nhầm với công việc bảo mật phòng thủ. Nhưng nó không nhằm thay thế toàn bộ. Chính Anthropic khuyên dùng Opus 5.5 làm mô hình hằng ngày. Cách dùng hiệu quả nhất là coi Fable như “chuyên gia cấp cao” được gọi vào khi việc khó, hoặc làm điều phối cho các mô hình rẻ hơn, kèm chế độ fast mode cho những lúc thời gian thật sự quan trọng.
Nguồn tham khảo#
- Anthropic: Introducing Claude Fable 5.2 and Claude Mythos 5.2
- TechCrunch: Anthropic releases new Mythos and Fable models amid RSI concerns (9/11/2026)
- CNBC: Anthropic releases Claude Fable 5.2 and Claude Mythos 5.2 ahead of IPO
- MacRumors: Anthropic Launches Claude Fable 5.2 and Mythos 5.2
- The Neuron: Everything That Happened in AI, 9/11/2026
- AI Agent Store: AI Agent News tháng 11/2026